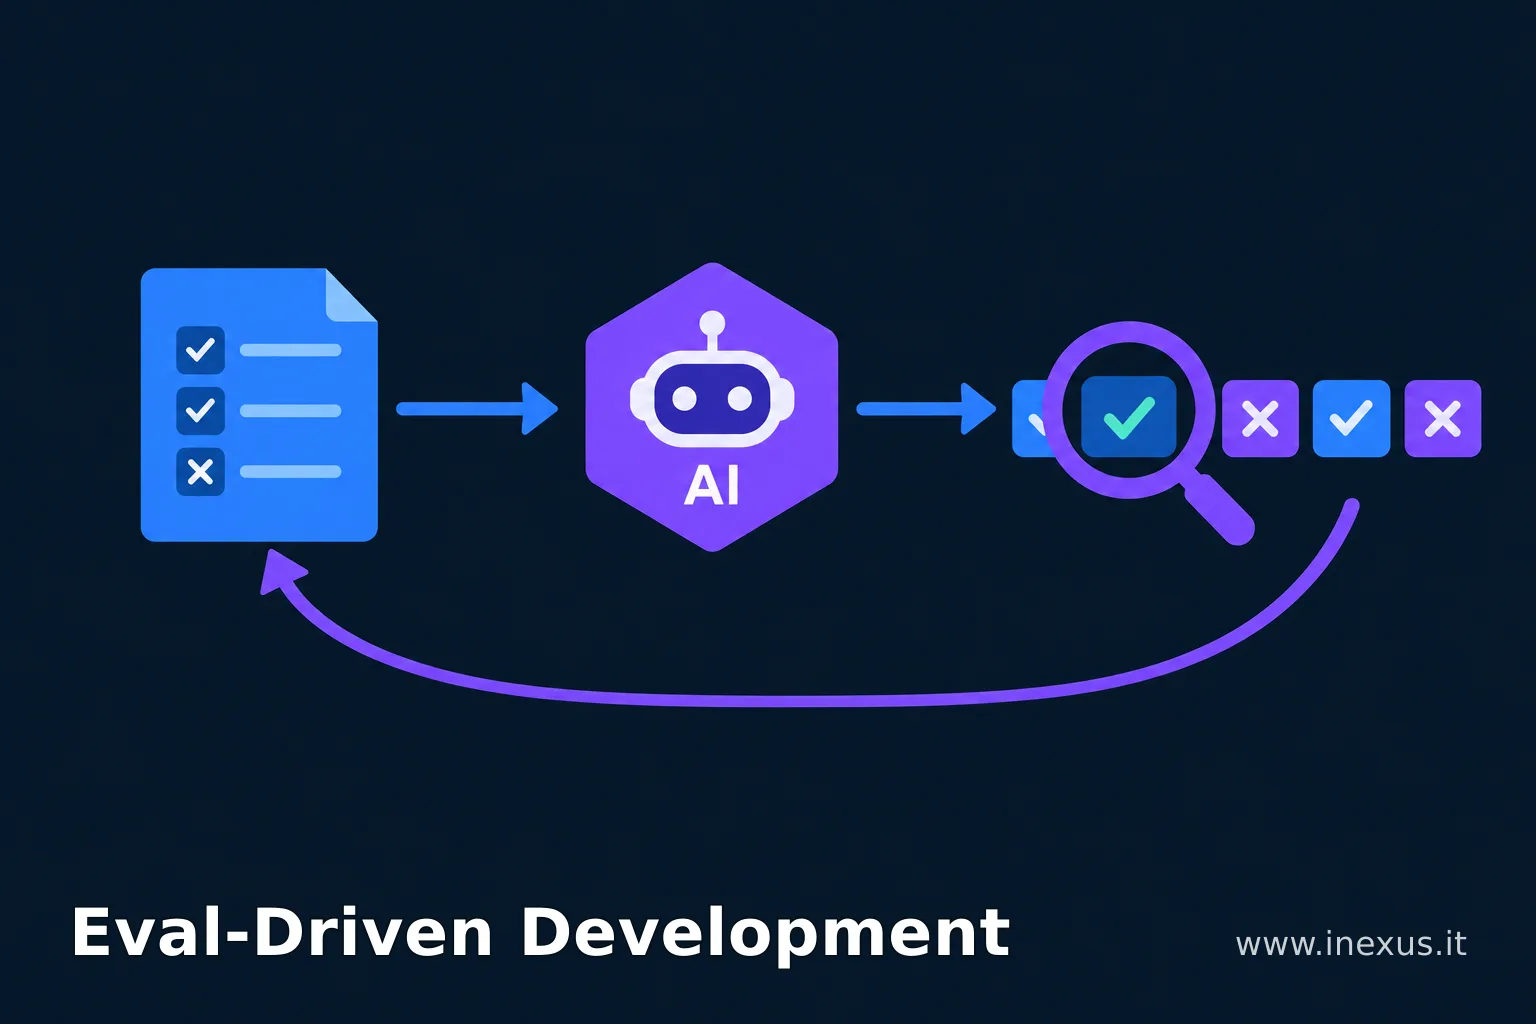
L'Eval-Driven Development (EDD) è un metodo per costruire agenti AI che parte da una lista di comportamenti attesi e da un documento di requisiti, per poi misurare ogni modifica con test automatici chiamati "eval" prima di portarla in produzione. L'obiettivo è sapere con certezza se un cambiamento ha migliorato l'agente o ne ha rotto il funzionamento altrove.
In breve
- L'EDD si ispira al test-driven development del software tradizionale, ma usa eval anziché test classici perché gli agenti AI sono non deterministici: la stessa domanda può produrre risposte diverse a ogni esecuzione.
- Il metodo si articola in tre passaggi: definire cosa significa "funzionare bene" per un comportamento, scrivere l'eval prima di costruire la funzione, confrontare ogni modifica con la versione precedente.
- Harbor, un framework open source citato nella guida, è alla base di benchmark di settore come Terminal-Bench: ogni compito gira in una sandbox dedicata e viene valutato da uno script che ne giudica l'esito.
- Un punteggio medio che sale può nascondere casi che smettono di funzionare: serve controllare ogni singolo esempio, non solo la media complessiva.
- Gli eval non si fermano allo sviluppo: restano attivi anche in produzione, per intercettare comportamenti che i test iniziali non avevano previsto.
Perché un agente AI non si può testare come un software tradizionale?
Un software tradizionale, a parità di input, produce sempre lo stesso output: per questo basta un test che confronta il risultato atteso con quello ottenuto. Un agente AI non funziona così, per tre motivi. Il primo è che gli output variano: la stessa domanda può ricevere risposte diverse a ogni esecuzione. Il secondo è che più di una risposta può essere corretta, perché due frasi scritte in modo diverso possono comunque essere entrambe valide. Il terzo è che l'agente sceglie da solo i propri passaggi: può usare uno strumento che non gli serviva, oppure saltarne uno necessario, e arrivare comunque alla risposta giusta.
Per queste ragioni servono eval invece di test rigidi: un eval assegna un punteggio alle esecuzioni dell'agente su un insieme di esempi, è più flessibile di un test classico e può valutare qualsiasi aspetto del comportamento, anche usando un altro modello linguistico come giudice (la tecnica nota come "LLM-as-a-judge").
Come funziona l'Eval-Driven Development in tre passaggi?
Il processo descritto si riduce a tre fasi: definire cosa significa "funzionare bene" per l'agente, scrivere l'eval prima di costruire la funzione, apportare la modifica e confrontare i risultati.
Nella prima fase si elenca il comportamento atteso: quando deve scattare, cosa l'agente deve fare, cosa non deve fare e quali comportamenti già esistenti devono continuare a funzionare. L'insieme di queste specifiche, comportamento per comportamento, costituisce il documento dei requisiti del prodotto (PRD). Lavorare su un solo comportamento alla volta evita che una modifica ne nasconda un'altra e permette di capire con chiarezza l'effetto di ogni cambiamento.
Nella seconda fase si costruisce un dataset, cioè una raccolta di casi di prova con un input e, quando possibile, una risposta di riferimento considerata corretta. Le esecuzioni reali dell'agente sono una delle fonti migliori per questi casi, perché gli utenti formulano le richieste in modi spesso imprevedibili e includono situazioni limite difficili da immaginare a tavolino. Se gli esempi assomigliano al traffico reale, un buon punteggio sull'eval è più rappresentativo di un comportamento effettivamente corretto una volta in produzione.
Nella terza fase si confronta ogni nuova versione dell'agente con quella precedente, un passaggio chiamato "hill-climbing": si ripete il ciclo di valutazione, confronto e correzione, così da avere prove oggettive di miglioramento a ogni passo.
Cosa sono gli eval e come si scrivono?
Un eval è lo strumento che trasforma la definizione di "comportamento corretto" scritta nel PRD in un punteggio misurabile su ogni esempio del dataset. Esistono due approcci principali: un controllo via codice, adatto quando la verifica è deterministica (per esempio controllare quale strumento ha chiamato l'agente), e un giudizio affidato a un altro modello linguistico, utile quando la verifica non può essere ridotta a una regola fissa. La scelta dipende da cosa si vuole osservare: la risposta finale dell'agente, i passaggi intermedi che ha compiuto, o entrambi.
Prima di apportare qualsiasi modifica, è utile eseguire una "baseline", cioè far girare l'agente su tutti gli esempi del dataset e registrare i risultati come punto di partenza: solo confrontando ogni versione successiva con questa base si può verificare se un cambiamento ha davvero introdotto un miglioramento.
Che ruolo ha Harbor nei benchmark come Terminal-Bench?
Harbor è un framework open source pensato per gli agenti che operano in ambienti più complessi, come un agente di programmazione che agisce dentro una sandbox. In questi casi non basta controllare qualche chiamata di strumento e la risposta finale: occorre verificare lo stato che l'agente lascia nel sistema al termine dell'esecuzione, e ogni prova deve partire da un ambiente pulito perché un'esecuzione non influenzi la successiva.
Harbor è il motore dietro benchmark di settore come Terminal-Bench, dove ogni compito gira nella propria sandbox dedicata e viene accompagnato da uno script di test che ne valuta l'esito finale. Ottimizzare le prestazioni su un benchmark di questo tipo segue la stessa logica dell'EDD: si scrivono prima i compiti e i test, si esegue una baseline, poi si confrontano gli esperimenti a ogni modifica apportata all'agente.
Quali errori evitare quando si valuta un agente AI?
Il primo errore è definire il successo in modo troppo vago: un criterio come "la risposta è utile" non è una metrica misurabile, mentre un criterio deve essere abbastanza preciso da poter essere giudicato come superato o fallito. Il secondo errore è scrivere l'eval dopo aver già visto il risultato della correzione: così facendo è facile costruire un test che passa per costruzione, mentre andrebbe scritto prima e verificato che fallisca sulla versione ancora difettosa dell'agente.
Il terzo errore è guardare solo il punteggio medio: un miglioramento della media può nascondere casi che hanno smesso di funzionare o comportamenti corretti che sono stati sovrascritti da una modifica successiva. Serve rivedere ogni esempio prima di confermare un cambiamento. Il quarto errore è aggiungere eval non necessari: ogni eval dovrebbe essere collegato a un comportamento specifico, un difetto da correggere o una funzione da introdurre. Il quinto, infine, è fidarsi di un giudice automatico (l'LLM-as-a-judge) senza averlo prima confrontato con un giudizio umano, e senza avergli posto domande ristrette con risposta sì/no invece di scale ambigue.
Come si continua a valutare l'agente dopo il rilascio?
Il dataset usato in fase di sviluppo copre quasi sempre solo i casi a cui si era pensato, mentre la produzione mostra situazioni nuove. Per questo l'EDD prevede che la valutazione prosegua anche dopo il rilascio, con alcuni strumenti complementari: valutatori online che assegnano un punteggio alle esecuzioni reali man mano che arrivano, campionando una parte del traffico per gestire i costi; code di revisione manuale, utili anche per verificare che un giudice automatico sia allineato al giudizio umano; cruscotti che tracciano nel tempo punteggi, costi e tempi di risposta, per capire se un nuovo rilascio ha migliorato o peggiorato la situazione; e strumenti che raggruppano le esecuzioni in produzione per individuare pattern ricorrenti, trasformandoli in nuovi casi da aggiungere al dataset di test.
Integrare gli eval nel flusso di lavoro quotidiano, per esempio accanto al codice con strumenti come pytest, permette di bloccare una modifica difettosa prima che raggiunga gli utenti e di individuare rapidamente eventuali regressioni.
Domande frequenti
L'Eval-Driven Development serve solo per agenti complessi o anche per assistenti semplici? Il metodo si applica a qualsiasi agente, da un chatbot con poche funzioni a un sistema che opera in ambienti complessi come una sandbox: cambia la complessità degli eval necessari, non la logica di fondo del processo.
Qual è la differenza tra un eval e un test software tradizionale? Un test tradizionale verifica che un output coincida esattamente con quello atteso; un eval assegna un punteggio su un insieme di esempi e tollera che esistano più risposte corrette o percorsi diversi per arrivare allo stesso risultato, perché l'agente è non deterministico.
Basta raggiungere un punteggio perfetto sul dataset per dire che l'agente è pronto? No: un punteggio perfetto su un dataset piccolo può indicare che l'agente si è adattato troppo a quegli esempi specifici (overfitting), continuando a sbagliare su richieste formulate in modo diverso. Per questo è utile tenere da parte un gruppo di esempi non usati durante le modifiche, da controllare separatamente.
Perché è importante guardare ogni esempio e non solo il punteggio medio? Perché una modifica può far salire la media pur facendo fallire un caso che prima funzionava correttamente: senza controllare i singoli esempi si rischia di introdurre regressioni senza accorgersene.
Fonti
- What Is Eval-Driven Development? How to Improve AI Agents — https://www.langchain.com/blog/what-is-eval-driven-development
Se la tua azienda sta valutando come costruire o migliorare un agente AI su misura, e vuoi capire come verificarne il comportamento prima che arrivi ai clienti, puoi approfondire i servizi di sviluppo AI di iNexus o scrivere per un confronto.