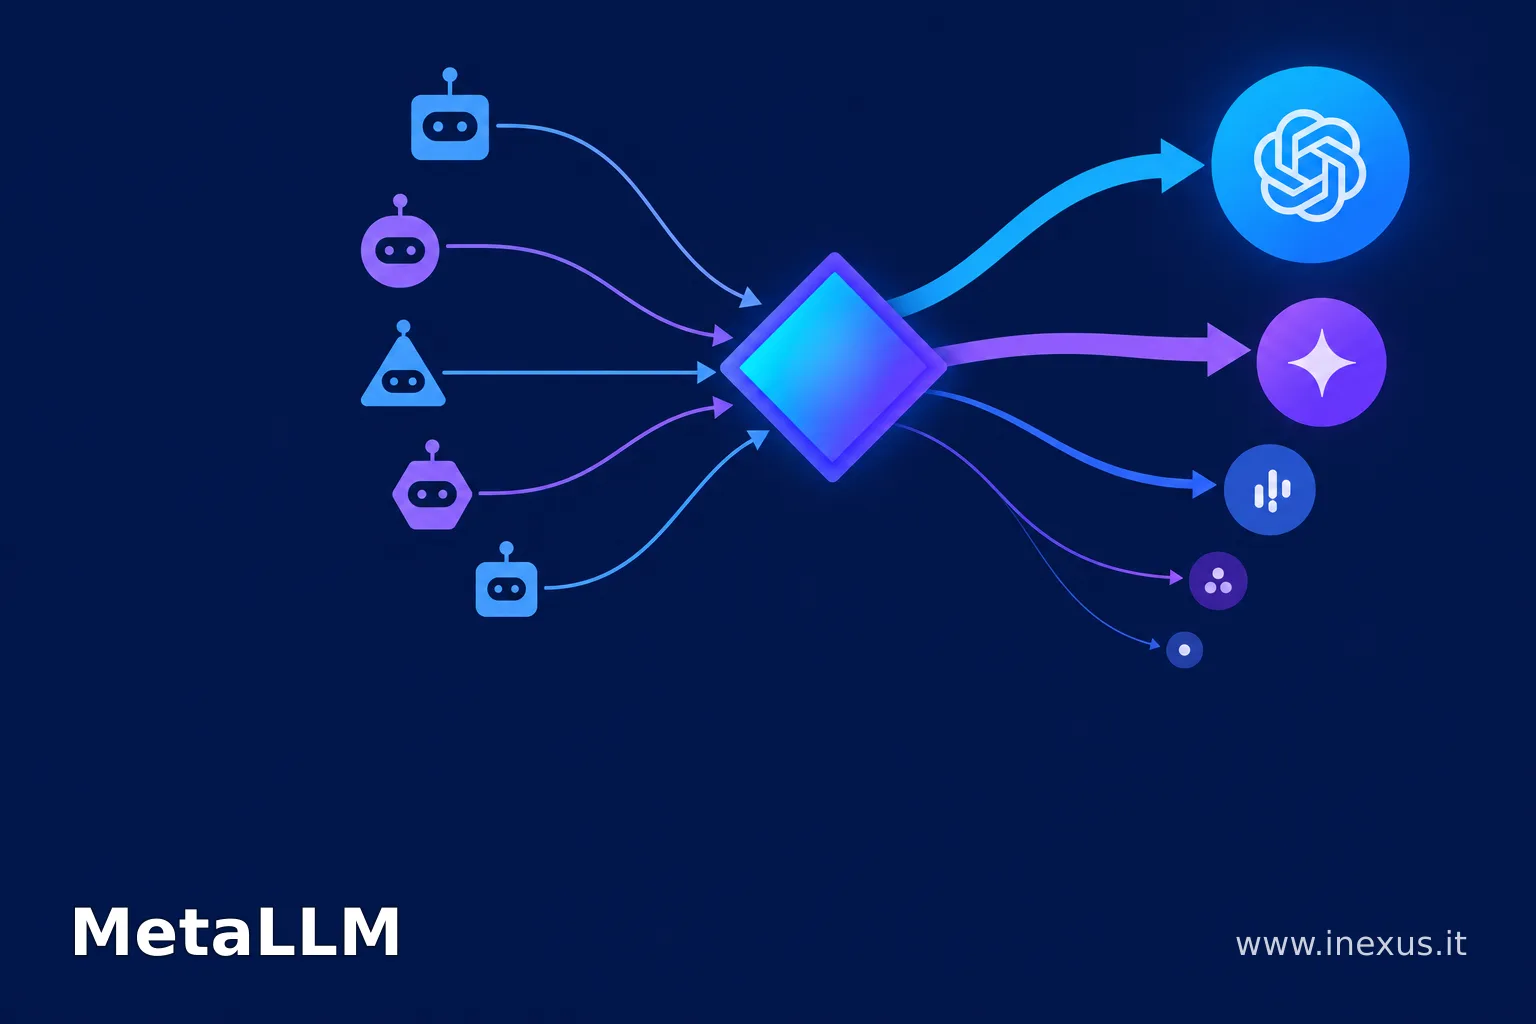
Quando un'azienda fa funzionare decine o migliaia di agenti AI in produzione, il conto dei token può crescere più in fretta dei benefici ottenuti. MetaLLM, presentato da Cognitum One al SEMA Show 2026 di Las Vegas, è un "control plane" che smista ogni richiesta verso il modello più economico in grado di completarla, impara dagli esiti passati per affidare sempre più lavoro a modelli a basso costo, e può correggere modelli edge direttamente nei loro pesi.
In breve
- Un "control plane" per modelli AI è uno strato software che decide quale modello elabora ciascuna richiesta, applicando regole aziendali su costo, sicurezza e governance.
- MetaLLM instrada il lavoro semplice verso modelli leggeri ospitati su infrastruttura locale e riserva i modelli "frontiera" solo ai compiti più complessi.
- Il sistema impara dagli esiti: più richieste gestisce, più affida lavoro ai modelli economici, evitando le combinazioni che in passato hanno fallito.
- Una tecnica di ricerca chiamata Weight-Space Programming permette di correggere un modello agendo direttamente sui suoi pesi, senza un nuovo ciclo di addestramento.
- Il problema del costo a token nasce anche da un vincolo contrattuale: i piani consumer dei modelli di largo consumo non sono adatti a dati aziendali riservati, e questo spinge le imprese a pagare le tariffe commerciali piene.
Cos'è un "control plane" per modelli AI?
Un control plane per modelli AI è lo strato di governo che si interpone tra le applicazioni aziendali e i modelli linguistici che effettivamente eseguono il lavoro. Non genera risposte: decide chi deve generarle, applicando le regole che l'organizzazione ha stabilito su costo, dati e conformità. Secondo la descrizione fornita da Cognitum One, MetaLLM è definito un "model management studio and governance control plane" pensato per gestire deployment multi-agente su infrastruttura aziendale locale.
Questo tipo di architettura diventa necessario quando un'azienda non lavora più con un singolo assistente AI, ma con sciami di agenti (agent swarms) che si attivano in parallelo per analizzare documenti, tracciare aggiornamenti, rispondere a richieste o eseguire controlli. Ogni agente, ogni chiamata a un modello, genera un costo: senza uno strato di governo, l'azienda perde sia la visibilità su dove va il budget, sia la possibilità di dimostrare quale output è stato effettivamente prodotto dai propri agenti autorizzati.
Come funziona il meccanismo di routing verso il modello più economico?
Il meccanismo funziona valutando la complessità di ogni singola richiesta prima di assegnarla a un modello. MetaLLM agisce come uno strato di proxy dinamico: pesa quanto è impegnativo il compito e lo instrada verso il modello più economico in grado di portarlo a termine, sia che quel modello giri su hardware locale sia che si trovi dietro un'API commerciale. Il lavoro di routine — analisi sintattica, controlli di stato, aggiornamenti — finisce su modelli leggeri ospitati sull'hardware dell'azienda; solo i compiti più difficili arrivano ai modelli più costosi e potenti.
La seconda parte del meccanismo è ciò che rende il sistema "self-improving": abbinato a una memoria auto-apprendente chiamata RuVector, MetaLLM conserva traccia di ogni compito completato con successo e di ogni schema che invece ha fallito. Ogni nuova decisione di instradamento attinge a questa storia: più tempo passa, più il sistema affida lavoro ai modelli economici con sicurezza, ed evita le combinazioni che in passato non hanno funzionato. In pratica, il costo medio per operazione tende a scendere nel tempo, non per effetto di uno sconto commerciale, ma perché il sistema impara dove può permettersi di usare un modello più semplice.
Quanto si può risparmiare instradando le richieste al modello giusto?
La cifra dipende interamente dal mix di carichi di lavoro e dalla tariffa dei modelli usati, ma un caso illustrativo aiuta a capire l'ordine di grandezza del problema. Cognitum One descrive uno scenario ipotetico in cui un'azienda fa girare 5.000 agenti che processano 100 milioni di token al giorno a 10 dollari per milione di token: la spesa annua si aggirerebbe intorno ai 365.000 dollari. Se l'80% di quel lavoro viene instradato verso modelli locali, la tariffa media scenderebbe a circa 2,50 dollari per milione di token, portando la spesa annua a circa 91.250 dollari.
È bene sottolineare che si tratta di uno scenario dichiaratamente ipotetico e illustrativo: il risparmio reale dipende dal carico di lavoro specifico, dal mix di modelli disponibili e dalle tariffe in vigore in ciascun contesto. Resta però utile come riferimento concettuale per chi deve valutare se investire in uno strato di routing intelligente ha senso rispetto a inviare ogni richiesta direttamente al modello più costoso disponibile.
Cos'è la correzione dei pesi "in-place" e perché interessa i modelli edge?
La correzione dei pesi in-place è una tecnica che permette di modificare il comportamento di un modello intervenendo direttamente sui suoi parametri numerici, senza eseguire un nuovo ciclo di addestramento. Il riferimento tecnico citato da Cognitum One è il Weight-Space Programming, una tecnica pubblicata da ricercatori del MIT CSAIL il 2 novembre 2026, non ancora sottoposta a revisione paritaria. Nello studio, un modello GPT-6 Astra ha letto i pesi grezzi di una rete neurale come se fossero testo e li ha riscritti con precisione, senza cicli di addestramento basati su gradiente né backpropagation. In un esperimento su un modello linguistico compatto, Qwen3.5-0.8B, la tecnica ha individuato un problema di ciclo ripetitivo, modificato lo 0,016% dei pesi del modello e portato il punteggio sul benchmark MATH-500 dal 7,9% al 48,1%.
Applicata a modelli edge — quelli che girano direttamente su dispositivi locali, come i veicoli connessi — questa logica consente a MetaLLM di intervenire quando un'istanza locale si blocca in un ragionamento ripetitivo o fatica su un compito specifico: il sistema può prendere un'istantanea dei pesi del modello bloccato, elaborare una correzione attraverso il proprio strato di proxy e riscriverla direttamente sul dispositivo, senza generare dati sintetici né lanciare un nuovo ciclo di addestramento. L'effetto pratico è trasformare i parametri di un modello in qualcosa di più vicino a un repository di codice aggiornabile a caldo: utile soprattutto dove un modello deve continuare a funzionare senza un passaggio di andata e ritorno verso il cloud.
Perché il costo a token è un problema strutturale per le aziende regolamentate?
Il problema nasce da un vincolo contrattuale, non solo da una questione di tariffe. I piani ad abbonamento flat che rendono accessibili molti agenti di coding per gli sviluppatori individuali operano sotto termini consumer, nei quali il fornitore può usare prompt e codice per migliorare i propri modelli. Le aziende regolamentate non possono inviare codice proprietario, dati dei clienti o informazioni sensibili attraverso quei termini, e si ritrovano quindi a dover acquistare ogni token alle tariffe API commerciali piene. Man mano che gli sciami di agenti crescono, cresce proporzionalmente il conto.
A questo si aggiunge un problema di tracciabilità: senza uno strato che certifichi l'origine dell'output, diventa difficile dimostrare quale testo o codice sia stato effettivamente prodotto da un agente autorizzato dell'organizzazione. Per questo motivo gli strumenti di questo tipo tendono a combinare instradamento economico, governo delle policy e marcatura crittografica dell'output in un'unica infrastruttura, piuttosto che lasciare ciascuna funzione a strumenti separati.
Domande frequenti
Cosa si intende per "routing" delle richieste AI? È il processo con cui uno strato software decide, per ogni singola richiesta, quale modello AI debba elaborarla, in base alla complessità del compito e alle regole di costo o di governo stabilite dall'organizzazione.
Un sistema di routing funziona sempre allo stesso modo nel tempo? No: nei sistemi con memoria auto-apprendente, ogni esito — positivo o negativo — viene registrato e usato per affinare le decisioni successive, spostando progressivamente più lavoro verso i modelli meno costosi quando l'esperienza lo conferma affidabile.
Correggere i pesi di un modello sostituisce l'addestramento? Non del tutto: la correzione dei pesi in-place agisce su problemi puntuali individuati in un modello già addestrato, modificando una porzione molto piccola dei suoi parametri, mentre l'addestramento resta il processo con cui un modello acquisisce le sue capacità di base.
Fonti
- ruvLLM | Self-Learning On-Device Inference Engine — ACCESS Newswire, 5 novembre 2026 — https://www.accessnewswire.com/newsroom/en/computers-technology-and-internet/cognitum-one-unveils-metallm-self-improving-model-control-plane-f-1247158
Se lavori nello sviluppo di applicazioni AI su misura e vuoi confrontarti su come impostare l'architettura di un agente o di un'automazione in modo sostenibile nel tempo, puoi scrivere a iNexus: un confronto iniziale aiuta a capire quali scelte tecniche hanno senso per il caso specifico.